La fin du modèle monolithique dans vos backends applicatifs
Le modèle du LLM unique est mort. Franchement, essayer de faire résoudre un problème métier complexe par un seul appel d'API relève de l'amateurisme. Vous avez tous essayé. Vous avez rédigé des prompts de trois pages en espérant que le modèle gère simultanément l'extraction de données, l'analyse sémantique, la prise de décision logique. Le tout formaté dans un JSON parfait pour votre application mobile iOS ou Android. Le résultat ? Des hallucinations à la chaîne. Une latence infernale. Un parsing qui casse une fois sur deux.
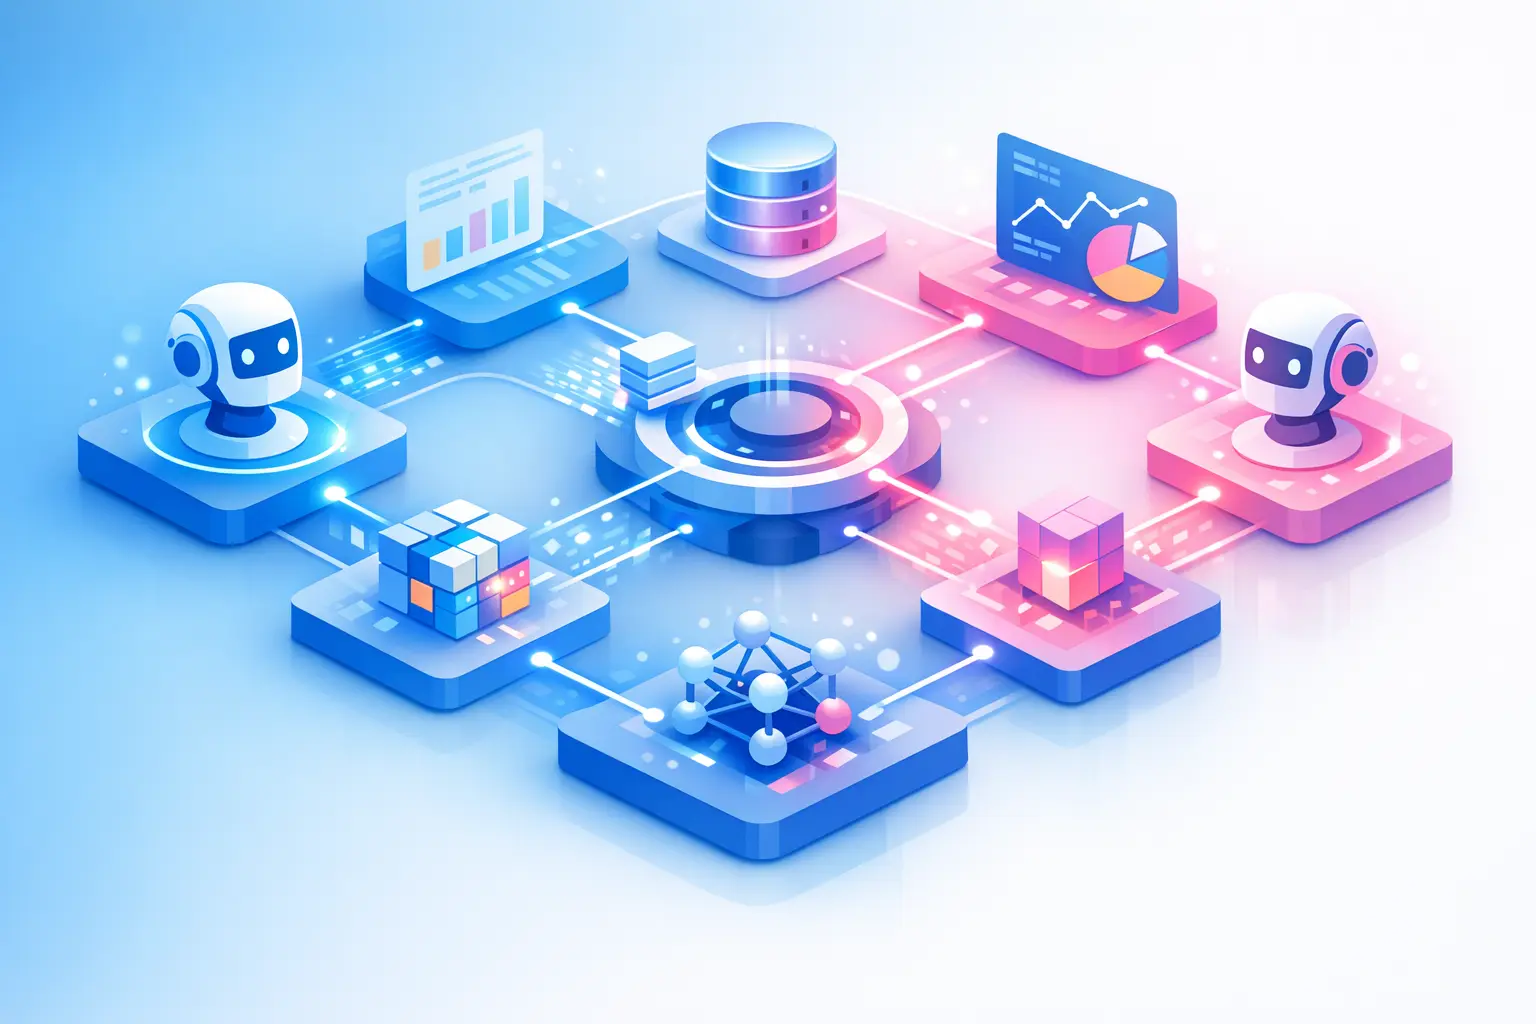
L'architecture applicative moderne exige une granularité fine. C'est ici qu'interviennent les workflows multi-agents. Au lieu de surcharger un seul modèle, vous distribuez la complexité. Vous créez un graphe d'exécution. Chaque noeud de ce graphe est un agent spécialisé. Un agent possède un rôle strict. Il a accès à des outils spécifiques. Il reçoit un contexte limité. Il exécute sa tâche. Puis il passe le relais.
Ce modèle imite le fonctionnement d'une équipe technique humaine. Vous avez un superviseur, des exécutants, des validateurs. Dans le contexte d'un backend mobile, cela change absolument tout. Votre application ne communique plus avec une "IA" générique. Elle déclenche un processus asynchrone complexe où plusieurs entités débattent pour fournir la réponse la plus optimisée possible. C'est puissant. C'est instable. C'est l'avenir.
Topologies de communication : quand les agents commencent à débattre
Concevoir ces chaînes de traitement nécessite de choisir une topologie réseau stricte. Vous ne pouvez pas laisser les agents discuter librement dans le vide. Cela génère des boucles infinies. Votre facture de tokens va exploser en quelques minutes. Vous devez imposer un cadre déterministe à un système: intrinsèquement probabiliste.
La topologie hiérarchique reste la plus fiable pour les produits numériques. Un agent superviseur reçoit le payload depuis le client mobile. Il analyse l'intention. Il fragmente le problème. Ensuite, il délègue.
Voici les étapes typiques d'un workflow hiérarchique bien conçu :
- Parsing strict de la requête entrante via des schémas Pydantic.
- Évaluation du contexte utilisateur stocké en base vectorielle.
- Délégation asynchrone aux agents spécialistes selon un routage sémantique.
- Exécution des appels API externes par les workers dédiés.
- Synthèse itérative ou critique des résultats partiels par un agent évaluateur.
- Formatage final du payload JSON pour le client mobile.
Chaque étape est isolée. Si l'agent chargé d'interroger la base de données financière échoue, le superviseur le remarque. Il relance la tâche avec de nouvelles instructions. L'application mobile, pendant ce temps, maintient une connexion ouverte. Elle attend la résolution du graphe.
Mais est-ce qu'on maîtrise vraiment la trajectoire de ces requêtes ? J'en doute souvent. La nature non-déterministe des LLMs rend le débogage de ces graphes particulièrement fastidieux. Vous tracez l'exécution, vous analysez les logs. Vous réalisez que l'agent critique a rejeté la réponse de l'agent chercheur pour une raison sémantique obscure. C'est fascinant. C'est aussi un cauchemar opérationnel.
Le cauchemar absolu du State Management asynchrone
Le state management. Un enfer. Littéralement. Dans une architecture REST classique, l'état est géré par la base de données. Avec les workflows multi-agents, l'état devient fluide. Il transite de noeud en noeud. Chaque agent modifie le contexte global.
Des frameworks comme LangGraph ou AutoGen tentent de standardiser cette gestion. Ils modélisent le flux sous forme de graphes acycliques dirigés. Vous définissez un objet d'état global. Chaque agent reçoit cet objet, le mute, le retourne. C'est élégant sur le papier. Dans la réalité d'un backend mobile à fort trafic, c'est une autre histoire.
Sauf que si le superviseur perd le fil du contexte asynchrone lors du retour réseau...
Vous devez persister cet état à chaque transition. Redis est souvent le candidat idéal pour cette tâche. Vous sérialisez l'état du graphe. Vous le stockez. Si le processus plante, vous reprenez l'exécution au dernier noeud validé. Malgré que vous utilisez ces bases de données en mémoire ultra-rapides, la surcharge d'I/O devient rapidement perceptible. Vous déplacez des mégaoctets de contexte textuel à chaque itération.
Faut-il partager toute la mémoire? Pas si simple. Un agent spécialisé dans l'analyse de sentiment n'a pas besoin de connaître l'historique complet des transactions bancaires de l'utilisateur. Vous devez implémenter des mécanismes de filtrage de contexte. Des fenêtres glissantes. Des résumés générés à la volée. C'est une ingénierie de la contrainte.
Latence réseau face aux exigences de l'UX mobile
Abordons le vrai problème. L'expérience utilisateur. Un mobinaute est impatient. Il tolère une latence de quelques centaines de millisecondes. Une seconde, c'est déjà trop long.
Or, un workflow multi-agents prend du temps. Beaucoup de temps. Plusieurs appels LLM séquentiels. Des temps de génération de tokens qui s'additionnent. Des appels d'outils externes. Résoudre un problème complexe peut prendre vingt, trente, voire soixante secondes. Comment gérer cette latence sur une interface mobile sans perdre l'utilisateur ?
La réponse réside dans le streaming asynchrone. Oubliez le protocole HTTP classique avec son cycle requête-réponse statique. Vous devez basculer sur des WebSockets ou des Server-Sent Events (SSE). Dès que l'application mobile envoie sa requête, le backend accuse réception instantanément. Ensuite, il pousse des événements en temps réel.
L'interface utilisateur doit refléter cette activité. Vous affichez des indicateurs de progression granulaires. "L'agent financier analyse votre portefeuille". "L'agent de risque évalue les scénarios". "L'agent rédacteur prépare votre synthèse". Vous transformez l'attente en un spectacle technique. Vous montrez la valeur du travail en cours.
L'asynchronisme total reste la seule architecture viable pour encaisser cette charge. Quoique, forcer des goulots d'étranglement synchrones sur les noeuds critiques garantit une intégrité transactionnelle que l'asynchrone détruit systématiquement. C'est un compromis permanent entre la réactivité de l'interface graphique face à la lourdeur des calculs sous-jacents.
Notre approche chez Kosmos Digital privilégie toujours la transparence de l'état. Le client mobile doit savoir exactement où en est le graphe d'exécution. C'est une règle absolue en design d'API moderne.
Sécuriser les frontières d'un système non-déterministe
La sécurité de ces architectures est un sujet sous-estimé. Un LLM unique présente déjà des risques d'injection de prompt. Un système multi-agents multiplie cette surface d'attaque par le nombre de noeuds dans votre graphe. C'est un vrai danger! Ne l'ignorez pas.
Imaginez un workflow conçu pour analyser des documents téléchargés par l'utilisateur via son smartphone. L'agent extracteur lit un PDF malveillant. Ce PDF contient des instructions cachées. L'agent extracteur, aveuglé, transmet ces instructions dans l'état global. L'agent superviseur lit cet état. Il exécute l'instruction malveillante. Il finit par exfiltrer des données sensibles via un appel API externe. C'est ce qu'on appelle une injection de prompt indirecte inter-agents.
Pour contrer cela, vous devez compartimenter. C'est le principe du moindre privilège appliqué à l'intelligence artificielle.
- Un agent routeur purement déterministe sans accès aux outils externes.
- Un pool d'agents créatifs restreints par des gardes-fous sémantiques stricts.
Les données que le superviseur a traité doivent être systématiquement sanitizées avant d'être passées au composant suivant. Vous ne pouvez pas faire confiance aux sorties d'un LLM. Jamais. Vous devez valider chaque transition d'état avec des parseurs robustes. Si le JSON retourné ne correspond pas au schéma attendu, vous rejetez la transition. Vous levez une exception.
Lors du dévelopement de l'application, ces mécanismes de sécurité ralentissent considérablement l'itération. Vous passez plus de temps à écrire des règles de validation qu'à concevoir l'intelligence métier. C'est le prix à payer pour déployer ces technologies en production.
Vous pouvez retrouver notre méthodologie détaillée sur la sécurisation des flux de données asynchrones. C'est un prérequis non négociable avant tout passage à l'échelle.
L'impact sur la scalabilité de l'infrastructure
Faire tourner ce genre de workflow pour un utilisateur est facile. Le faire tourner pour cent mille utilisateurs simultanés sur une application mobile grand public exige une infrastructure redoutable.
Chaque exécution de graphe consomme de la mémoire. Maintient des connexions réseau ouvertes. Sollicite des API tierces facturées à la milliseconde. Votre backend doit être capable de provisionner des workers à la volée. Vous devez implémenter des files d'attente robustes. Kafka ou RabbitMQ deviennent vos meilleurs alliés.
Vous devez aussi gérer les limites de taux de vos fournisseurs de LLM. Si OpenAI ou Anthropic vous bloquent parce que vos agents font trop de requêtes concurrentes, tout votre produit numérique s'effondre. Vous implémentez alors des stratégies de backoff exponentiel. Vous mettez en cache les réponses sémantiquement similaires. Vous déployez des modèles locaux plus petits pour les agents de routage afin d'économiser les appels externes coûteux.
Je me demande parfois si nous ne créons pas des usines à gaz inmaintenables. La complexité architecturale explose. Le débogage nécessite de tracer des identifiants de corrélation à travers des dizaines de microservices asynchrones.
Pourtant, quand le système fonctionne, la magie opère. L'utilisateur obtient une réponse d'une précision chirurgicale. Une réponse qu'aucun algorithme classique n'aurait pu générer. Certaines de nos références illustrent parfaitement ce saut qualitatif. Le retour sur investissement justifie largement l'effort d'ingénierie initial.
Bref. L'ère des agents autonomes collaboratifs ne fait que commencer. Maîtriser leur orchestration dans un contexte mobile contraint fera la différence entre une application gadget vouée à disparaître face à un produit numérique véritablement intelligent. Les outils sont là. Les concepts se stabilisent. À vous de concevoir les bonnes chaînes de traitement.