L'origine d'un malentendu tenace sur la culture technique
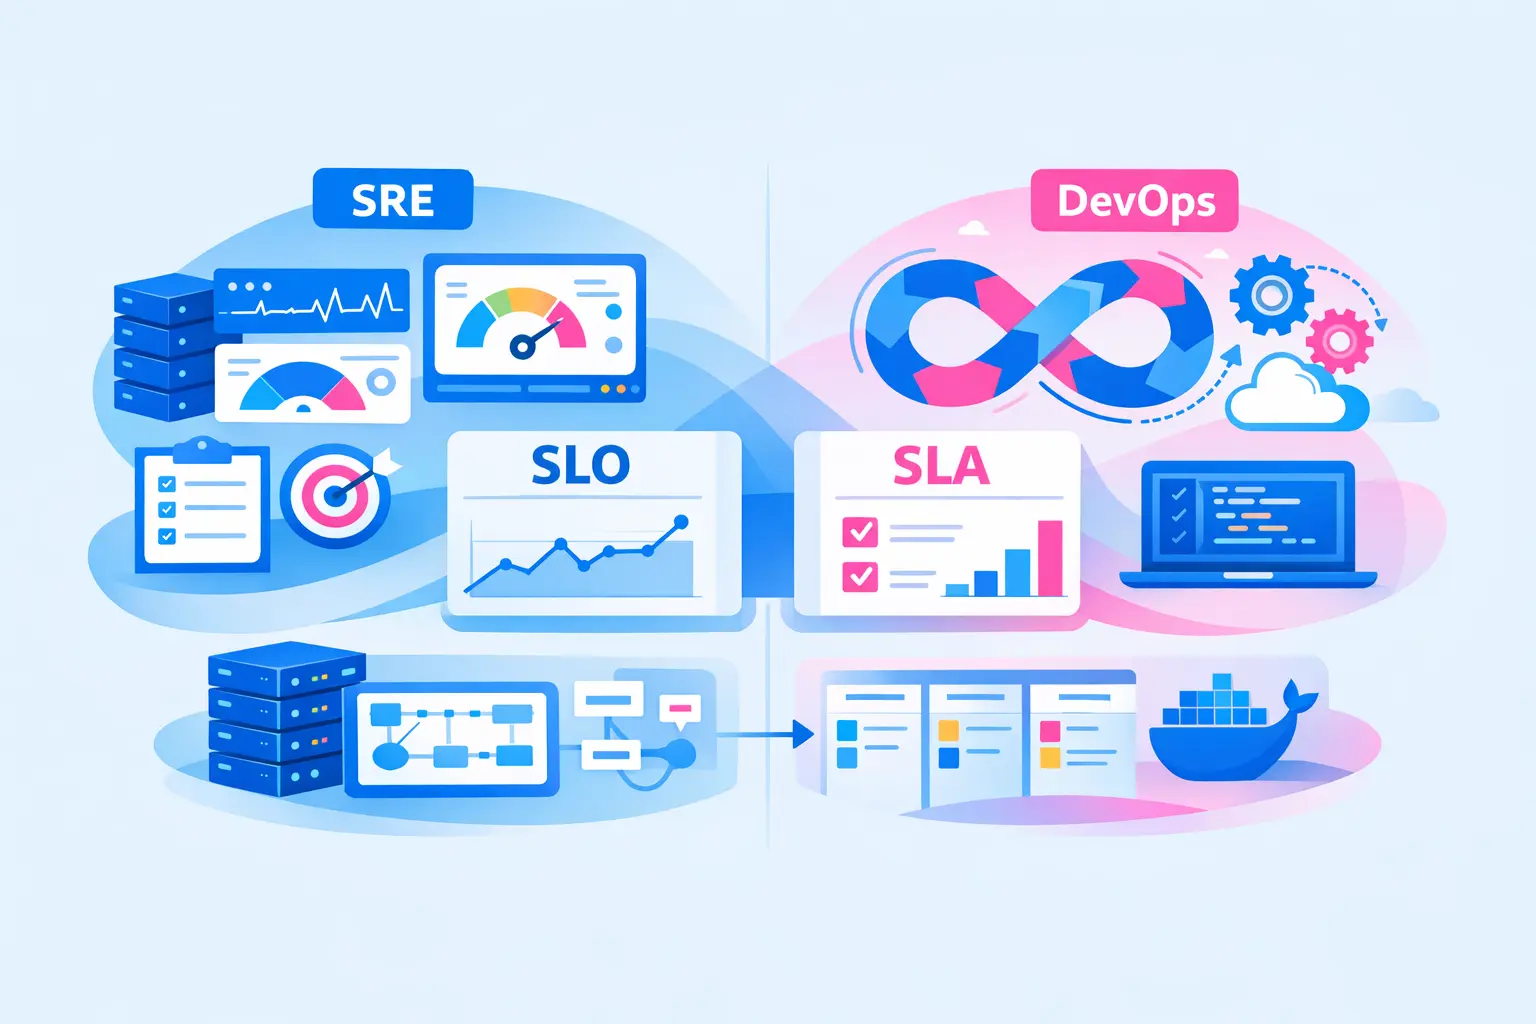
Vous entendez le terme DevOps partout. Bon, c'est devenu un mot-valise. Un concept abstrait. Le SRE, c'est différent. C'est une discipline d'ingénierie. C'est factuel. Le SRE est fondamentalement la même chose que le DevOps. C'est juste l'application concrète des mêmes principes. Une façon de forcer la collaboration par les mathématiques.
Le DevOps s'attaque aux silos. Historiquement, vous aviez deux équipes isolées dans la chaîne de valeur.
- Le développeur produit la fonctionnalité métier.
- L'ingénieur système maintient l'infrastructure sous-jacente.
Ces deux mondes se détestaient copieusement. Le développeur veut le changement. L'opérateur veut la stabilité. Le DevOps tente de réconcilier ces deux forces. Sauf que la philosophie ne suffit pas toujours à maintenir une API mobile sous forte charge. L'intention est louable. L'exécution technique pèche souvent par manque de rigueur.
La tyrannie des métriques pures face aux signaux dorés
C'est ici que le SRE entre en jeu. Le SRE s'oppose presque philosophiquement au DevOps. Là où le DevOps veut accélérer sans cesse, le SRE agit comme un frein d'urgence. Un garde-fou mathématique indéniable.
Oubliez les tableaux de bord remplis de graphiques inutiles. La santé d'un backend mobile ne se résume pas à l'usage CPU d'un serveur Linux. Vous devez mesurer ce qui impacte réellement l'utilisateur final sur son smartphone.
Les ingénieurs ont défini des signaux dorés. Vous devez surveiller ces métriques spécifiques avec une attention paranoïaque.
- La latence des appels API depuis l'application mobile cliente.
- Le taux d'erreurs HTTP 5xx renvoyé par vos microservices.
- Le volume de trafic simultané lors des pics d'utilisation soudains.
- La saturation de vos bases de données relationnelles principales.
- Le taux de requêtes rejetées violemment par votre rate limiter.
- La consommation mémoire de vos workers asynchrones en Go.
- L'accumulation de messages non traités dans vos files d'attente Kafka.
Parce que si l'on regarde la dégradation de la latence p99 sur un réseau mobile 3G instable...
Bref. Vous devez comprendre la différence exacte entre SLO, SLI et SLA. Ce n'est pas qu'une soupe alphabétique pour managers. C'est le cœur de votre stratégie de fiabilité technique.
Le SLI est votre indicateur. C'est la métrique brute extraite de vos sondes. Par exemple, le temps de réponse de l'API de paiement. Le SLO est votre objectif interne. Vous visez 99,9% de requêtes traitées en moins de 200 millisecondes. Le SLA est le contrat commercial liant l'entreprise. Si vous ne respectez pas vos engagements de disponibilité, vous payez des pénalités financières.
Les erreurs que vous avez fait dans le passé viennent souvent de cette confusion systémique. Vous avez défini des SLA commerciaux avant même de mesurer vos SLI techniques. C'est une hérésie architecturale complète. Vous vous engagez sur des chiffres que votre code ne peut pas soutenir physiquement.
Le budget d'erreur comme outil de négociation implacable
Voici le concept le plus puissant du SRE moderne. L'acceptation totale de l'échec. Un système disponible à 100% n'existe pas. C'est physiquement impossible sur des réseaux distribués. Les pannes réseau existent. Les disques durs meurent. Les routeurs BGP perdent leurs tables de routage sans prévenir.
Si votre SLO est de 99,9% de disponibilité sur un mois glissant. Vous disposez d'un budget d'erreur de 43,2 minutes. Pendant ces 43 minutes, votre service peut être totalement hors ligne. C'est assumé par toute l'entreprise.
Vous épuisez ce budget. Que fait-on ensuite ?
Vous arrêtez tout. Pas de nouvelles fonctionnalités. Pas de mise en production de code métier optionnel. Vous consacrez 100% de votre temps d'ingénierie à restaurer la fiabilité globale. Vous remboursez votre dette technique accumulée.
C'est souvent difficile à faire accepter aux équipes produit. Les chefs de projet veulent toujours plus de nouveautés. Mais les mathématiques ne mentent pas. Si les alertes ont été ignoré la semaine dernière, vous en payez le prix comptant aujourd'hui.
Notre méthodologie intègre directement ce mécanisme de budget d'erreur mathématique. Cela permet de rationaliser les discussions tendues entre les développeurs backend et les équipes produit. Fini les débats émotionnels interminables. Place aux données chiffrées indiscutables.
Les mensonges de la moyenne
Les moyennes sont des mensonges mathématiques rassurants. Ne regardez jamais le temps de réponse moyen de votre backend mobile. C'est une métrique fondamentalement trompeuse.
Imaginez cent requêtes entrantes. Quatre-vingt-dix-neuf d'entre elles prennent dix millisecondes. La dernière prend dix secondes entières. La moyenne vous donne environ cent dix millisecondes. Vous pensez que votre système est performant. Vous avez tort.
Cet utilisateur unique qui a attendu dix secondes vient de désinstaller votre application iOS. Il a laissé un avis négatif destructeur sur l'App Store.
Le SRE s'appuie exclusivement sur les percentiles. Le p90, le p95, le p99. Si votre p99 est de deux cents millisecondes, cela signifie que 99% de vos utilisateurs expérimentent une latence inférieure. Vous vous concentrez sur la pire expérience utilisateur mesurable. C'est la seule façon de garantir une qualité de service réelle sur des terminaux mobiles hétérogènes.
Le problème du troupeau déchaîné
Prenons un cas pratique très courant sur les architectures mobiles. Le problème du troupeau déchaîné.
Votre application envoie une notification push à un million d'utilisateurs simultanément. C'est une excellente nouvelle pour le département marketing. C'est un cauchemar absolu pour l'infrastructure réseau.
Un million de smartphones se réveillent instantanément. Ils ouvrent des connexions TLS lourdes vers votre API Gateway. Ils demandent tous la même ressource JSON en même temps. Vos serveurs sont submergés. Le pool de connexions à la base de données sature. Le système s'effondre sous son propre succès fulgurant.
Un DevOps classique va provisionner plus de serveurs virtuels. Il va configurer des règles d'auto-scaling agressives pour réagir au pic de charge.
Un ingénieur SRE va modifier le comportement du client mobile lui-même. Il va imposer un délai aléatoire avant que l'application ne contacte le serveur. Il va implémenter un mécanisme de circuit breaker côté backend pour rejeter proprement les requêtes excédentaires. Il va limiter le taux de requêtes avec un algorithme de token bucket strict.
La fiabilité ne se résout pas toujours en ajoutant de la puissance de calcul brute. L'architecture logicielle doit être intrinsèquement défensive.
Le labeur manuel et l'automatisation par la contrainte
Le quotidien d'un ingénieur SRE ne ressemble pas à celui d'un administrateur système traditionnel. Le travail manuel répétitif est l'ennemi public numéro un. On appelle cela le "toil". Le labeur sans valeur.
Redémarrer un service manuellement. Ajouter de la capacité en cliquant dans une interface web confuse. Gérer les tickets de support de niveau 1. Tout cela n'a aucune valeur ajoutée à long terme. Le SRE plafonne strictement ce labeur à 50% du temps de travail global.
Les 50% restants servent à concevoir des systèmes résilients par nature. À écrire du code complexe pour remplacer le travail manuel des humains. À faire du capacity planning pour anticiper le Black Friday sur votre application e-commerce. Le dévellopement de ces outils internes est crucial pour la survie de l'équipe.
Je me demande parfois si Google applique encore ses propres préceptes SRE à la lettre aujourd'hui. Les systèmes sont devenus tellement tentaculaires. Peut-être que même eux naviguent à vue sur certains de leurs microservices obscurs. L'industrie tech adore idéaliser les géants du web californiens. La réalité interne est souvent beaucoup plus chaotique qu'on ne l'imagine.
En parcourant l'architecture détaillée sur notre site, vous verrez que l'ingénierie de la fiabilité exige une discipline de fer au quotidien. Surtout pour les architectures orientées événements hautement concurrentes.
L'astreinte est un autre point de friction majeur. Dans un modèle de gestion traditionnel, l'équipe des opérations gère les pannes à trois heures du matin. Ils subissent la mauvaise qualité du code écrit par d'autres développeurs. C'est injuste.
Le modèle SRE partage cette responsabilité critique. Les développeurs participent activement aux rotations d'astreinte nocturnes. Si votre code déclenche une alerte critique en pleine nuit, vous vous réveillez. C'est une boucle de feedback redoutable. Vous apprenez très vite à écrire du code robuste quand votre propre sommeil est directement en jeu.
L'observabilité dépasse largement le simple monitoring
Le monitoring classique vous dit qu'un système est en panne. L'observabilité vous explique exactement pourquoi. C'est une distinction fondamentale pour déboguer vos applications mobiles.
Un utilisateur ouvre votre application. L'écran d'accueil charge à l'infini. Le monitoring de l'API Gateway indique pourtant que les serveurs tournent parfaitement. Le CPU est à 20%. La mémoire est stable. Tout semble vert sur les écrans de contrôle.
Erreur fatale!
Vous avez un problème de contention sur une base de données NoSQL située cinq couches réseau plus bas. Sans traçage distribué complet, vous êtes aveugle. Vous devez pouvoir suivre une requête HTTP unique de bout en bout. Depuis le smartphone de l'utilisateur jusqu'au cluster de base de données enfoui dans votre réseau privé.
Analysez nos références pour voir comment une observabilité fine transforme la gestion des incidents majeurs. Vous passez d'une posture réactive stressante à une véritable ingénierie proactive maîtrisée.
Les métriques doivent être corrélées mathématiquement. Les logs doivent être structurés en JSON. Les traces doivent être échantillonnées intelligemment pour ne pas saturer le réseau. C'est un travail d'ingénierie titanesque.
Il ne suffit pas d'installer un outil open source populaire pour devenir subitement résilient. L'architecture de votre système: elle-même doit permettre cette observabilité native. Vous devez injecter des identifiants de corrélation uniques dès le premier load balancer rencontré.
L'ingénierie du chaos complète parfaitement cette démarche SRE exigeante. Vous ne pouvez pas avoir confiance en votre résilience si vous ne la testez pas en conditions réelles.
Il s'agit d'injecter volontairement des pannes sévères dans votre environnement de production. Vous éteignez des serveurs virtuels aléatoirement. Vous introduisez de la latence artificielle sur le réseau local. Vous supprimez des tables de routage critiques.
Cela paraît fou pour un esprit non initié. C'est pourtant la seule méthode empirique valable pour valider vos hypothèses de résilience matérielle.
Si votre architecture repose sur des microservices découplés, la défaillance d'un composant non critique ne doit jamais paralyser l'application mobile entière. Le moteur de recommandation tombe en panne à cause d'une surcharge ? L'utilisateur doit toujours pouvoir finaliser son achat sans encombre. L'interface mobile masquera simplement la section des recommandations défectueuses. C'est le principe de dégradation gracieuse appliquée.
La gestion des incidents ne s'arrête pas quand le service est enfin rétabli. C'est là que le vrai travail d'analyse SRE commence vraiment.
L'analyse post-mortem sans blâme est strictement non négociable. Quand une panne majeure survient sur votre infrastructure, la question n'est jamais de savoir qui a fait l'erreur technique. L'erreur humaine est une fatalité inévitable. C'est une donnée d'entrée du système complexe.
La vraie question est purement systémique. Pourquoi le système a-t-il permis à cette erreur humaine isolée de provoquer une panne globale en cascade ?
Vous devez rédiger un document technique détaillé. Vous documentez la chronologie exacte de l'incident à la seconde près. Vous analysez les causes racines profondes. Vous identifiez les signaux d'alerte préalables manqués par vos équipes. Vous créez des tickets pour améliorer l'observabilité défaillante. Vous concevez des garde-fous logiciels supplémentaires.
Pas de pitié. Zéro complaisance intellectuelle. Qu'est-ce qui génère du labeur? Vous l'éliminez par du code.
L'ingénierie de la fiabilité est une discipline impitoyable par essence. Elle expose toutes les faiblesses cachées de votre infrastructure cloud. Elle met en lumière la moindre latence réseau ignorée. Elle quantifie vos échecs avec une précision chirurgicale.
Vous devez accepter cette rigueur technique absolue.